构建可扩展、安全且易管理的数据处理与分析系统 赋能在线数据处理与交易处理业务
引言
在数字化浪潮下,企业越来越依赖数据驱动的决策。在线数据处理与交易处理业务(如实时风控、订单处理、用户行为分析、金融交易等)对系统的可扩展性、安全性和易管理性提出了极高要求。一个设计良好的数据处理与分析系统,不仅能支撑海量并发事务,还能从数据中快速提炼洞察,直接驱动业务增长。
本文将围绕“可扩展、安全、易于管理”三大核心目标,探讨如何构建支持在线数据处理与交易处理业务的数据系统架构。
一、在线数据处理与交易处理业务的特点
在线数据处理与交易处理(OLTP)通常具备以下特征:
- 高并发:大量用户同时发起请求,如电商秒杀、支付交易。
- 低延迟:要求毫秒级响应,保证用户体验。
- 强一致性:交易数据必须准确、不重复、不丢失。
- 混合负载:既要处理实时交易,又要进行实时分析或离线报表。
- 7×24 可用性:系统停机将直接造成业务损失。
这些特点决定了系统必须同时兼顾交易处理与分析能力,即 HTAP(混合事务/分析处理)或 Lambda/Kappa 架构的演进。
二、可扩展性设计:从垂直扩展到水平分片
1. 分层架构与解耦
将系统分为接入层、计算层、存储层和管理层。各层之间通过明确定义的接口通信,便于独立扩展。例如:
- 接入层使用负载均衡(如 Nginx、LVS)分发请求。
- 计算层采用无状态服务,支持容器化水平扩展。
- 存储层根据数据类型选择关系型数据库、NoSQL、消息队列或数据湖。
2. 分布式数据库与分片
对于交易处理,可使用分布式数据库(如 TiDB、OceanBase、CockroachDB)实现自动分片和弹性扩展。分片键设计需避免热点,保证数据均匀分布。
3. 流式与批处理结合
- 实时链路:Kafka + Flink/Spark Streaming 处理实时数据流,写入在线存储或数据湖。
- 离线链路:Hive/Spark 处理历史数据,生成报表和模型。
- 通过统一元数据管理,避免数据孤岛。
4. 弹性伸缩机制
基于 Kubernetes 的 HPA(水平 Pod 自动伸缩)或云厂商的自动扩展组,根据 CPU、内存或自定义指标(如消息积压)动态调整资源。
三、安全性设计:贯穿数据全生命周期
1. 数据加密
- 传输加密:TLS/SSL 保护数据传输。
- 存储加密:透明数据加密(TDE)或文件系统加密。
- 密钥管理:使用 KMS 集中管理密钥,定期轮换。
2. 访问控制与认证
- 基于角色的访问控制(RBAC)或属性基访问控制(ABAC)。
- 多因素认证(MFA)保护管理后台。
- 最小权限原则,限制服务账户权限。
3. 审计与合规
- 记录所有数据访问和操作日志,采用不可篡改存储(如区块链或 WORM 存储)。
- 满足 GDPR、等保 2.0、PCI DSS 等合规要求。
4. 隐私保护
- 数据脱敏、假名化或差分隐私技术用于分析场景。
- 敏感数据识别与分类,自动打标。
5. 容灾与备份
- 多云或跨区域部署,实现故障隔离。
- 定期备份与恢复演练,确保 RPO/RTO 达标。
四、易管理性设计:自动化与可观测性
1. 基础设施即代码(IaC)
使用 Terraform、Ansible 等工具定义和管理基础设施,保证环境一致性,降低人为错误。
2. 统一监控与告警
- 指标:Prometheus + Grafana 采集和展示系统指标(QPS、延迟、错误率、资源使用率)。
- 日志:ELK/EFK 栈集中管理日志,支持快速检索。
- 链路追踪:Jaeger/SkyWalking 追踪分布式请求,定位瓶颈。
- 告警:Alertmanager 或 PagerDuty 实现分级告警。
3. 自动化运维
- CI/CD 流水线:Jenkins/GitLab CI 实现自动构建、测试和部署。
- 混沌工程:定期注入故障,验证系统韧性。
- 自愈机制:基于健康检查自动重启或替换故障节点。
4. 元数据与数据治理
- 数据目录:记录数据来源、含义、血缘关系。
- 数据质量监控:定期校验完整性、唯一性、时效性。
- 生命周期管理:自动归档冷数据,降低存储成本。
五、典型架构参考
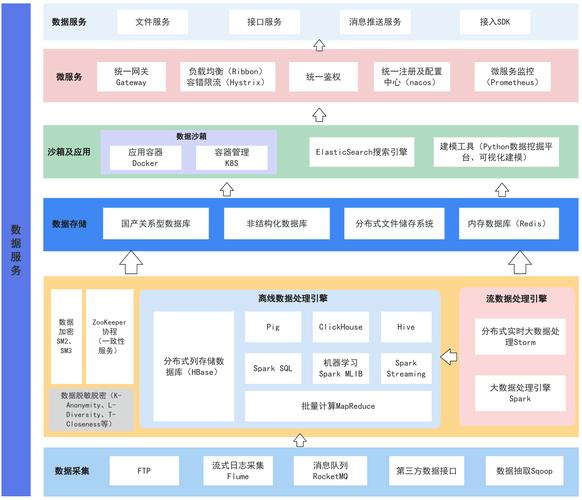
以下是一个支持在线数据处理与交易处理的参考架构:
- 接入层:API Gateway + 负载均衡,负责鉴权、限流、路由。
- 交易处理层:微服务集群,使用分布式事务框架(如 Seata)保证一致性,数据库采用分库分表。
- 消息队列:Kafka 或 Pulsar,解耦生产者和消费者,缓冲峰值流量。
- 实时计算层:Flink 进行窗口聚合、CEP 复杂事件处理,结果写入 Redis 或 ClickHouse 供快速查询。
- 存储层:
- 热数据:Redis、TiDB
- 温数据:ClickHouse、Doris
- 冷数据:S3/HDFS + 数据湖格式(Iceberg/Hudi)
- 分析层:Spark/Trino 进行交互式分析,ML 模型训练与推理。
- 管理层:Kubernetes 编排,Prometheus 监控,ELK 日志,Vault 密钥管理。
六、最佳实践与注意事项
- 从业务出发:不要过度设计,根据业务增长逐步演进。
- 数据一致性权衡:在线交易优先强一致,分析场景可最终一致。
- 预留扩展点:接口设计保持抽象,避免技术绑定。
- 安全左移:在开发阶段引入安全扫描和代码审计。
- 培养 SRE 文化:开发与运维协同,共同为稳定性负责。
七、结论
构建可扩展、安全且易于管理的数据处理与分析系统,是一项持续演进的工程。对于在线数据处理与交易处理业务而言,系统不仅是支撑工具,更是核心竞争力。通过合理的分层架构、分布式技术选型、全链路安全防护以及自动化运维体系,企业能够从容应对海量并发交易,并从数据中实时获得洞察,真正实现数据驱动的业务增长。
未来十年,随着云原生、Serverless 和 AI 原生数据库的发展,这类系统将变得更加弹性、智能和自治。企业应保持技术敏锐度,持续优化架构,以在数字时代保持领先。
如若转载,请注明出处:http://www.gywzseo.com/product/18.html
更新时间:2026-10-13 01:20:06